- 리뷰
- 리스트
- 구매
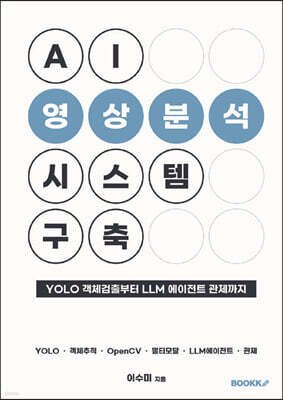
AI 영상분석 시스템 구축
- 글쓴이
- 이수미 저
- 출판사
- BOOKK(부크크)
- 출판일
- 2026년 10월 19일
읽고있어요
다 읽었어요
읽고싶어요
저자
이수미
삼성(현 한화)에어로스페이스에서 시스템 시뮬레이션 엔지니어로 실무 경력을 쌓은 후, 재능대학교 겸임교수, 한국폴리텍대학 강사, 강원대학교 강사로 활동하며 호서대학교 벤처대학원에서 융합공학(인공지능 전공)으로 공학박사 학위를 취득하였다. 현재 배재대학교 겸임교수로 재직 중이며, ICT 인프라·데이터·인공지능을 아우르는 융합 교육을 실천하고 있다.
저서로는 『바이브코딩』, 『생성형AI 활용 첫걸음』, 『게임인공지능 첫걸음』, 『AI활용논문작성법』, 『라우팅&스위칭 첫걸음』, 『데이터과학』, 『할로코드 스마트하우스』, 『Let’s 자율주행 엠봇2』가 있으며, 본서는 아홉 번째 저작이다.
저서로는 『바이브코딩』, 『생성형AI 활용 첫걸음』, 『게임인공지능 첫걸음』, 『AI활용논문작성법』, 『라우팅&스위칭 첫걸음』, 『데이터과학』, 『할로코드 스마트하우스』, 『Let’s 자율주행 엠봇2』가 있으며, 본서는 아홉 번째 저작이다.
책 소개
분야IT 모바일
화면 속 차량을 세는 검출에서 상황을 판단해 보고하는 에이전트까지, 관제 시스템 하나를 처음부터 끝까지 직접 구축한다.
누구나 AI 모델을 내려받아 실행해 볼 수 있는 시대다. 그러나 검출 모델을 한 번 실행해 보는 일과 현장에서 24시간 동작하는 시스템을 만드는 일은 전혀 다른 문제다. 현장의 검출 모델은 추적, 집계, 해석, 판단으로 이어지는 시스템의 한 부품이다. 이 책은 그런 시스템을 구축하는 전 과정을 다룬다.
교통 CCTV 관제라는 하나의 현장을 3부 18장이 이어 간다.
1부 딥러닝 영상분석 기초에서는 YOLO26으로 차량·보행자를 검출하고, 추적으로 동일 객체를 연결해 방향별 통행량을 집계한다. 검출 성능을 정밀도·재현율로 측정하고 오검출·미검출을 분석하는 체계까지 갖춘다.
2부 LLM 연동 영상분석에서는 검출이 만든 수치를 LLM이 해석해 상황 보고서와 알림 문안을 생성한다. 계산과 판정은 코드가, 서술은 LLM이 맡는 분업 원칙으로 환각을 통제하고, 실패에 대비한 장애 대응 설계까지 담았다.
3부 에이전트 AI 관제 시스템에서는 LangGraph 에이전트가 요청을 읽고 스스로 도구를 골라 실행한다. 대화형 질의, VLM 장면 판독, 통행량 예측을 거쳐 마지막 장에서 자율 관제 프로토타입을 완성한다.
모든 실습은 무료 도구와 무료 사용량 안에서, GPU 없는 컴퓨터로 재현되도록 구성했다. 본문의 실행 결과는 저자가 실제 교통 영상으로 직접 실행해 얻은 수치다.
[이 책의 특징]
- 하나의 현장, 끝까지. 장마다 소재가 바뀌는 예제 모음이 아니라, 교통 관제 시스템 하나를 1장부터 18장까지 이어서 완성한다. 검출 대상과 감지 규칙을 바꾸면 방범·제조·시설 관리로 그대로 이전된다.
- 실측으로 쓴 본문. 실행 로그, 처리 시간, 오검출 사례(기차·시계로 잘못 분류된 실제 화면)까지 저자가 직접 실행한 결과로 서술했다.
- 수식은 계산까지. 모든 수식은 기호 풀이, 숫자 대입 계산, 실습 코드의 인자 연결 순서로 다룬다. 수식이 부담스러운 독자는 숫자 예만 따라가면 된다.
- 장마다 자주 하는 오해. 실습이 막히는 지점을 오개념 단위로 정리했고, 연습문제는 계산·측정 문제 위주로 구성했다.
- 현장 제약까지. API 요금 산정, 개인정보와 외부 전송, 폐쇄망을 위한 온프레미스·로컬 LLM 구성(부록 C)을 다룬다.
[대상 독자]
- 영상분석 자동화를 검토하는 ITS·관제 현장의 실무자
- 처음으로 영상분석 시스템을 만드는 개발자
- 자기 분야의 화면 데이터에 AI를 접목하려는 실무자
- 한 학기 강의로 AI 영상분석을 가르치는 교수자
파이썬 기초만 있으면 충분하며, 고가의 장비는 필요하지 않다.
누구나 AI 모델을 내려받아 실행해 볼 수 있는 시대다. 그러나 검출 모델을 한 번 실행해 보는 일과 현장에서 24시간 동작하는 시스템을 만드는 일은 전혀 다른 문제다. 현장의 검출 모델은 추적, 집계, 해석, 판단으로 이어지는 시스템의 한 부품이다. 이 책은 그런 시스템을 구축하는 전 과정을 다룬다.
교통 CCTV 관제라는 하나의 현장을 3부 18장이 이어 간다.
1부 딥러닝 영상분석 기초에서는 YOLO26으로 차량·보행자를 검출하고, 추적으로 동일 객체를 연결해 방향별 통행량을 집계한다. 검출 성능을 정밀도·재현율로 측정하고 오검출·미검출을 분석하는 체계까지 갖춘다.
2부 LLM 연동 영상분석에서는 검출이 만든 수치를 LLM이 해석해 상황 보고서와 알림 문안을 생성한다. 계산과 판정은 코드가, 서술은 LLM이 맡는 분업 원칙으로 환각을 통제하고, 실패에 대비한 장애 대응 설계까지 담았다.
3부 에이전트 AI 관제 시스템에서는 LangGraph 에이전트가 요청을 읽고 스스로 도구를 골라 실행한다. 대화형 질의, VLM 장면 판독, 통행량 예측을 거쳐 마지막 장에서 자율 관제 프로토타입을 완성한다.
모든 실습은 무료 도구와 무료 사용량 안에서, GPU 없는 컴퓨터로 재현되도록 구성했다. 본문의 실행 결과는 저자가 실제 교통 영상으로 직접 실행해 얻은 수치다.
[이 책의 특징]
- 하나의 현장, 끝까지. 장마다 소재가 바뀌는 예제 모음이 아니라, 교통 관제 시스템 하나를 1장부터 18장까지 이어서 완성한다. 검출 대상과 감지 규칙을 바꾸면 방범·제조·시설 관리로 그대로 이전된다.
- 실측으로 쓴 본문. 실행 로그, 처리 시간, 오검출 사례(기차·시계로 잘못 분류된 실제 화면)까지 저자가 직접 실행한 결과로 서술했다.
- 수식은 계산까지. 모든 수식은 기호 풀이, 숫자 대입 계산, 실습 코드의 인자 연결 순서로 다룬다. 수식이 부담스러운 독자는 숫자 예만 따라가면 된다.
- 장마다 자주 하는 오해. 실습이 막히는 지점을 오개념 단위로 정리했고, 연습문제는 계산·측정 문제 위주로 구성했다.
- 현장 제약까지. API 요금 산정, 개인정보와 외부 전송, 폐쇄망을 위한 온프레미스·로컬 LLM 구성(부록 C)을 다룬다.
[대상 독자]
- 영상분석 자동화를 검토하는 ITS·관제 현장의 실무자
- 처음으로 영상분석 시스템을 만드는 개발자
- 자기 분야의 화면 데이터에 AI를 접목하려는 실무자
- 한 학기 강의로 AI 영상분석을 가르치는 교수자
파이썬 기초만 있으면 충분하며, 고가의 장비는 필요하지 않다.
전체 리뷰 (0)
최근 작성 순