- 리뷰
- 리스트
- 구매
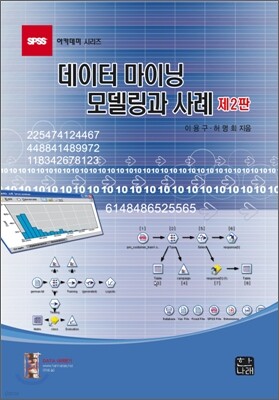
데이터 마이닝 모델링과 사례
- 글쓴이
- 허명회 저
- 출판사
- 한나래
- 출판일
- 2008년 2월 10일
읽고있어요
다 읽었어요
읽고싶어요
저자
허명회
서울대학교 계산통계학과를 졸업하였으며, 미국 스탠포드 대학교 대학원에서 통계학 박사 학위를 받았다. 현재 고려대학교 정경대학 통계학과 교수이다. 주요 저서로는 『SPSS'를 활용한 통계적 방법론』, 『R을 활용한 탐색적 자료분석』, 『다변량 수량화』, 『사회과학을 위한 통계적 방법』, 『탐색적 자료분석』, 『통계계산』,『행렬의 이해와 계산』, 『데이터 시각화』 등이 있다.
책 소개
분야대학교재
이 책은 데이터 마이닝에서 활용되는 대표적인 모형화 방법들에 대한 이론적인 설명과 함께 널리 알려진 마이닝 툴인 Clementine을 이용한 실제 응용 예제를 제시하여 독자들이 데이터 마이닝에 대하여 이론적 이해뿐만 아니라 실질적인 활용이 가능하도록 하였다. 이 책에 활용된 마이닝 툴인 clementine도 매년 새로운 버전이 나와 처음에는 버전 7 이었으나 현재는 버전 11이 출시되어 획기적인 발전을 하였다. 따라서 Clementine도 명실상부하게 기업의 대용량 자료를 이용한 데이터마이닝 분석을 실시할 수 있는 마이닝 툴로서 더욱 완벽한 모양을 갖추게 되었다.
이러한 Clementine의 향상으로 개정판에서는 버전 7로 된 응용사례들을 버전 11로 전환하였으며 일부 내용도 수정 보완 하였다. 또한 Clementine에 새로 추가된 방법들 중에서 실질적인 마이닝 프로젝트에서 중요하게 활용될 수 있는 방법들인 의사결정 리스트(Decision List), 변수선택(Future
Selection), 이상치 탐색(Anomaly Decision), 그리고 이단계 군집화(Two-step Clustering)등을 추가하였다. 이를 통해 데이터마이닝에 대한 이론적 학습뿐만 아니라 실제 현장에서 마이닝 프로젝트를 수행하는데 이 책이 많은 실질적 도움이 될 것으로 기대되어 진다
전체 리뷰 (0)
최근 작성 순