- 리뷰
- 리스트
- 구매
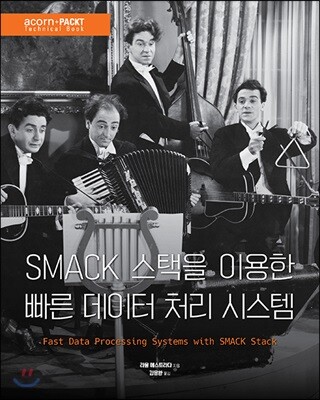
SMACK 스택을 이용한 빠른 데이터 처리
- 글쓴이
- 라울 에스트라다 저
- 출판사
- 에이콘출판사
- 출판일
- 2017년 12월 13일
읽고있어요
다 읽었어요
읽고싶어요
저자
라울 에스트라다
1996년부터 프로그래머로 일하기 시작해 2001년부터는 자바 개발자로 일하고 있다. 스칼라(Scala), 엘릭서(Elixir), 클로저(Clojure), 해스켈(Haskell) 같은 함수형 언어와 컴퓨터과학과 관련된 모든 주제를 아주 좋아한다. 가용성(High Availability) 및 엔터프라이즈 소프트웨어 분야에서 12년 넘게 경력을 쌓았고 2003년부터 아키텍처 설계 및 구현을 시작했다. 전문 분야는 시스템 통합이며 주로 금융 부문과 관련된 프로젝트에 참여했다. BEA 시스템즈(BEA Systems)와 오라클(Oracle)의 엔터프라이즈 아키텍트지만, 모바일 프로그래밍 및 게임 개발도 즐긴다. 그는 자신을 아키텍트, 엔지니어, 개발자보다 프로그래머라고 생각한다. 또한 아파치 플링크(Apache Flink), 아파치 카프카(Apache Kafka), 아파치 빔(Apache Beam) 같은 데이터 파이프 라이닝 관련 오픈소스 프로젝트에 중점을 둔 샌프란시스코 베이 에어리어(SanFrancisco Bay Area)의 크로스피터(Crossfitter)기도 하다. 자유 소프트웨어의 지지자이며 새로운 기술, 프레임워크, 언어, 방법을 실험하고 있다.
책 소개
분야IT 모바일
데이터 파이프라인 처리 아키텍처에서는 멀티 테넌시(multi-tenancy), 확장, 대용량 처리, 실시간 데이터 처리를 지원해야 한다. 따라서 외국에서는 해당 이슈를 해결할 수 있는 방법으로 하나의 오픈소스가 아닌 여러 오픈소스를 묶어(스택) 데이터 프로세싱을 처리하기 위해 다양한 시도를 하고 있다.
이런 분위기 속에서 2016년에 샌프란시스코 베이 에어리어(San Francisco Bay Area)의 데이터 엔지니어링 회의 및 컨퍼런스에서 "Spark, Mesos, Akka, Cassandra, Kafka Laying down the SMACK on your datapipelines"(링크: https://goo.gl/ny5Lwm, 발표 동영상: http://goo.gl/XVuxj8)라는 주제가 발표됐고, 이에 영향을 받아 관련 내용이 책으로 출판됐다. 이 책에서는 데이터 인메모리(in-memory) 분산 컴퓨팅 기능이 포함된 스파크(Spark), 클러스터 OS(Cluster OS), 분산 시스템 관리, 스케줄링, 확장 기능이 포함된 메소스(Mesos), 스칼라 언어의 액터 모델의 구현인 아카(Akka), 영속성 계층인 noSQL 데이터베이스인 카산드라(Cassandra), 분산 스트리밍 플랫폼(메시지 브로커)인 카프카(Kafka)를 기반으로 데이터 파이프라인 아키텍처를 구성하는 SMACK 스택을 소개한다. 개별 컴포넌트를 쉽게 설명했으며, 파이프라인 스택에 대한 아키텍처를 배우기에 적절하다.
이런 분위기 속에서 2016년에 샌프란시스코 베이 에어리어(San Francisco Bay Area)의 데이터 엔지니어링 회의 및 컨퍼런스에서 "Spark, Mesos, Akka, Cassandra, Kafka Laying down the SMACK on your datapipelines"(링크: https://goo.gl/ny5Lwm, 발표 동영상: http://goo.gl/XVuxj8)라는 주제가 발표됐고, 이에 영향을 받아 관련 내용이 책으로 출판됐다. 이 책에서는 데이터 인메모리(in-memory) 분산 컴퓨팅 기능이 포함된 스파크(Spark), 클러스터 OS(Cluster OS), 분산 시스템 관리, 스케줄링, 확장 기능이 포함된 메소스(Mesos), 스칼라 언어의 액터 모델의 구현인 아카(Akka), 영속성 계층인 noSQL 데이터베이스인 카산드라(Cassandra), 분산 스트리밍 플랫폼(메시지 브로커)인 카프카(Kafka)를 기반으로 데이터 파이프라인 아키텍처를 구성하는 SMACK 스택을 소개한다. 개별 컴포넌트를 쉽게 설명했으며, 파이프라인 스택에 대한 아키텍처를 배우기에 적절하다.
전체 리뷰 (0)
최근 작성 순