- 리뷰
- 리스트
- 구매
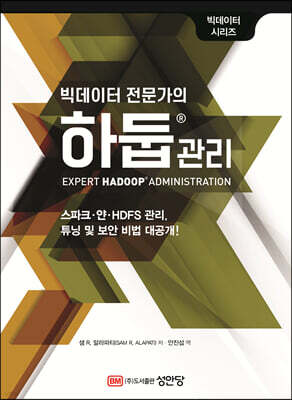
빅데이터 전문가의 하둡 관리
- 글쓴이
- 샘 R. 알라파티 저
- 출판사
- 성안당
- 출판일
- 2023년 5월 24일
읽고있어요
다 읽었어요
읽고싶어요
저자
샘 R. 알라파티
미국 텍사스 주, 사우스레이크에 본사를 두고 있는 사브레(Sabre) 사의 수석 하둡 관리자로서 매일 수많은 하둡 클러스터를 관리하고 있다. 모든 하둡 관리에 대한 자문위원으로서 사브레 사의 EDA(기업 데이터 분석, Enterprise Data Analytics) 그룹의 일원으로 일하고 있으며 하둡의 잡 플로와 관련해서 다수의 중요 데이터 과학과 데이터 분석 작업을 관리하고 최적화하는 일을 한다. 샘은 오라클 데이터베이스 관리 전문가이기도 한다. 그의 관계형 데이터베이스와 SQL에 대한 풍부한 지식은 하둡을 이용한 다수의 프로젝트를 성공으로 이끌었다. 샘의 데이터베이스와 미들웨어에서의 성과는 14년에 걸쳐 18권의 저서에 고스란히 담겨있다. 대부분 오라클 데이터베이스 관리와 오라클 웹로직 서버에 대한 것들이다. 샘은 『Modern Linux Administration(현대 리눅스 관리)』(오라일리(O’Reilly), 2017)의 저자이기도 하다. 수년에 걸쳐 그가 했던 수많은 시스템 설정, 아키텍처, 성능 관련 하둡 이슈들 다루어온 샘의 경험은 하둡 인프라를 만들고 관리하고 보안을 강화하고 최적화하려고 하는 많은 현역의 하둡 관리자들과 개발자들에게 좋은 참고서가 되고 있다.
책 소개
분야IT 모바일
하둡은 2003, 2005년에 발표된 구글 분산 파일 시스템(GFS)과 맵리듀스((MapReduce)를 구현한 것으로 대량의 자료를 처리할 수 있는 대형 컴퓨터 클러스터에서 동작하는 분산 응용 프로그램을 지원하는 프리웨어 자바 소프트웨어 프레임워크를 말한다. 하둡 관리자로서의 기술적인 배경과 집필 경험이 풍부한 샘 R. 알라파티(Sam R. Alapati)는 『빅데이터 전문가의 하둡 관리』를 통해 하둡에 대한 큰 그림을 볼 수 있도록 해준다. 하둡 생태계의 하둡 컴포넌트들인 아브로, 플룸, HBase, HCatalog, 하이브, 휴, 카프카, 머하웃, 우지, 피그, 스룹, 스톰, 테즈 등은 하나하나가 책 한 권으로도 나와 있을 만큼 큰 주제이지만 이 책에서는 이런 솔루션들을 빠짐없이 소개하고 언급한다.
저자는 하둡 생태계에서 크게 얀과 하둡 분산 파일 시스템(HDFS)을 배치하면서 하둡으로 배치, 인터랙티브, 실시간 데이터 접근을 위해서는 스크립트로는 피그, SQL로는 하이브, 스파크, 자바 스칼라로는 캐스케이딩, 스트림으로는 스파크 스트리밍, 인메모리로는 스파크, 검색으로는 솔라(Solr), NoSQL로는 HBase와 어큐뮬로, 머신러닝으로는 스파크 MR과 스파크 R 등을 사용한다며 하둡의 핵심 컴포넌트와 툴을 한눈에 보여준다. 또 하둡을 관리하기 위해 알아야 하는 것, 하둡 1과 2의 차이점을 다룸으로써 하둡 3 시대에도 대비할 수 있도록 하며, 하둡 관리의 핵심 영역까지 소개해준다.
저자는 하둡 생태계에서 크게 얀과 하둡 분산 파일 시스템(HDFS)을 배치하면서 하둡으로 배치, 인터랙티브, 실시간 데이터 접근을 위해서는 스크립트로는 피그, SQL로는 하이브, 스파크, 자바 스칼라로는 캐스케이딩, 스트림으로는 스파크 스트리밍, 인메모리로는 스파크, 검색으로는 솔라(Solr), NoSQL로는 HBase와 어큐뮬로, 머신러닝으로는 스파크 MR과 스파크 R 등을 사용한다며 하둡의 핵심 컴포넌트와 툴을 한눈에 보여준다. 또 하둡을 관리하기 위해 알아야 하는 것, 하둡 1과 2의 차이점을 다룸으로써 하둡 3 시대에도 대비할 수 있도록 하며, 하둡 관리의 핵심 영역까지 소개해준다.
전체 리뷰 (0)
최근 작성 순