- 리뷰
- 리스트
- 구매
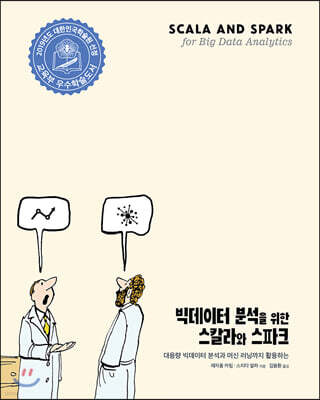
빅데이터 분석을 위한 스칼라와 스파크
- 글쓴이
- 레자울 카림 외 1명
- 출판사
- 에이콘출판사
- 출판일
- 2018년 12월 24일
읽고있어요
다 읽었어요
읽고싶어요
저자
레자울 카림
알고리즘 및 데이터 구조, C / C ++, 자바(Java), 스칼라(Scala), R 및 파이썬(Python)과 스파크(Spark), 카프카(Kafka), DC/OS, 도커(Docker), 메소스(Mesos), 하둡(Hadoop) 및 맵리듀스(MapReduce)와 같은 빅데이터 기술에 중점을 두면서 연구 개발 분야에서 8년 이상의 경력을 쌓았다. 머신 러닝, 심층 학습, 시맨틱 웹, 빅데이터 및 생물 정보학 분야 연구에 관심을 두고 있다. 『Large Scale Machine Learning with Spark』(Packt, 2016)의 저자다.
현재 아일랜드의 데이터 분석 센터에서 근무하는 소프트웨어 엔지니어이자 연구원이다. 또한 골웨이에 있는 아일랜드 국립대학교(National University of Ireland)의 박사 후보자며, 컴퓨터 공학 학사 및 석사 학위를 취득했다. 데이터 분석 센터에 입사하기 전에는 삼성전자에서 리드 소프트웨어 엔지니어로 일하면서 한국, 인도, 베트남, 터키, 방글라데시 등 전 세계에 분산돼 있는 삼성 R&D 센터에서 일했다. 또한 경희대학교 데이터베이스 연구소의 연구 조교로 근무했다. 그는 한국에 있는 BMTech21 Worldwide에서 R&D 엔지니어로 일했고 그 전에는 방글라데시 다카의 i2SoftTechnology에서 소프트웨어 엔지니어로 일했다.
현재 아일랜드의 데이터 분석 센터에서 근무하는 소프트웨어 엔지니어이자 연구원이다. 또한 골웨이에 있는 아일랜드 국립대학교(National University of Ireland)의 박사 후보자며, 컴퓨터 공학 학사 및 석사 학위를 취득했다. 데이터 분석 센터에 입사하기 전에는 삼성전자에서 리드 소프트웨어 엔지니어로 일하면서 한국, 인도, 베트남, 터키, 방글라데시 등 전 세계에 분산돼 있는 삼성 R&D 센터에서 일했다. 또한 경희대학교 데이터베이스 연구소의 연구 조교로 근무했다. 그는 한국에 있는 BMTech21 Worldwide에서 R&D 엔지니어로 일했고 그 전에는 방글라데시 다카의 i2SoftTechnology에서 소프트웨어 엔지니어로 일했다.
책 소개
분야IT 모바일
스파크를 이용해 데이터 분석 방법을 배우려는 사람에게 매우 유용한 책이다. 가장 먼저 스칼라를 소개하고, 스칼라 애플리케이션 개발에 필요한 객체지향 개념과 함수형 프로그래밍 개념을 설명한다. 스파크에 초점을 맞춰 RDD와 데이터 프레임을 사용한 기본 추상화를 다룬다. 그 다음 스파크 SQL, GraphX, 스파크 구조화 스트리밍을 사용해 구조화된 데이터와 구조화되지 않은 데이터를 분석하고 모니터링, 설정, 디버깅, 테스팅, 배포와 같은 고급 주제를 살펴본다. 또한 SparkR 및 PySpark API를 사용한 스파크 애플리케이션을 개발하는 방법, 아파치 제플린(Zeppelin)을 사용한 대화식 데이터 분석, Alluxio를 함께 사용해 인메모리 데이터를 처리하는 방법을 다룬다. 이 책을 다 살펴본 후, 스파크를 완벽하게 이해하고 풀 스택 데이터 분석을 수행할 수 있을 것이다. 이 책은 최신 2.3.2 버전을 기준으로 작성됐다. 기존의 원서에서 제공하는 코드의 오타와 호환성을 수정한 옮긴이의 github 저장소를 제공한다.
전체 리뷰 (0)
최근 작성 순