- 리뷰
- 리스트
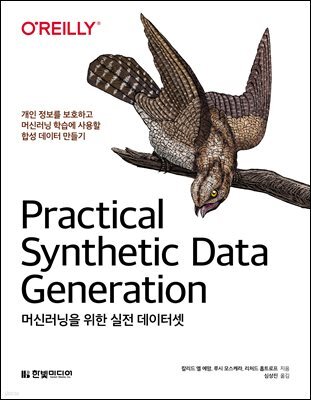
[eBook] 머신러닝을 위한 실전 데이터셋
- 글쓴이
- 칼리드 엘 에맘 외 2명
- 출판사
- 한빛미디어
- 출판일
- 2021년 1월 11일
읽고있어요
다 읽었어요
읽고싶어요
저자
칼리드 엘 에맘
Eastern Ontario Research Institute의 아동병원 선임 과학자이자 종합적인 전자 건강 정보연구소 소장으로 합성 데이터 생성 방법과 도구에 대한 응용 학술 연구를 수행하고 재식별 위험성을 측정한다. 또 오타와 대학교 의과대학 교수로 재직 중이다.
칼리드는 의료산업에서 인공지능과 머신러닝(Artificial Intelligence and Machine Learning, AIML)의 응용을 추진하기 위해 합성 데이터 개발에 주력하는 Replica Analytics의 공동 설립자다. 동시에 데이터 보호 기술을 개발하고 의료 서비스를 제공하며 신약 발명을 지원하는 분석 도구를 구축하는 기술 회사의 이사회에서 투자, 자문, 이사를 겸임하고 있다.
칼리드는 의료산업에서 인공지능과 머신러닝(Artificial Intelligence and Machine Learning, AIML)의 응용을 추진하기 위해 합성 데이터 개발에 주력하는 Replica Analytics의 공동 설립자다. 동시에 데이터 보호 기술을 개발하고 의료 서비스를 제공하며 신약 발명을 지원하는 분석 도구를 구축하는 기술 회사의 이사회에서 투자, 자문, 이사를 겸임하고 있다.
책 소개
분야IT 전문서
<b>개인 정보 보호와 광범위한 데이터 사용의 균형을 이루다.</b></br></br>머신러닝 모델을 구축하고, 테스트를 진행하려면 크고 다양한 종류의 데이터가 필요하다. 그러나 대부분의 데이터셋은 개인 정보 문제로 사용이 제한적이라 광범위하게 사용할 수 없다. 이 책에서는 실제 데이터로 새로운 데이터를 만드는 실용적인 합성 데이터 기술을 소개한다. 합성 데이터는 이차 분석에 용이하여 데이터 연구, 고객 행동의 이해, 신제품 개발 등 다양한 목적으로 활용될 수 있다. </br></br>이 책은 실제 데이터를 합성해 다양한 산업에서 사용할 수 있는 방법을 제공하며, 개인 정보 문제를 해결하는 방법을 다룬다. 또한 실제 데이터셋에서 합성 데이터를 생성하기 위한 원칙과 단계를 배운다. 더 나아가 합성 데이터가 제품이나 솔루션 개발에 드는 시간을 어떻게 단축할 수 있는지를 학습한다. </br>
전체 리뷰 (0)
최근 작성 순